

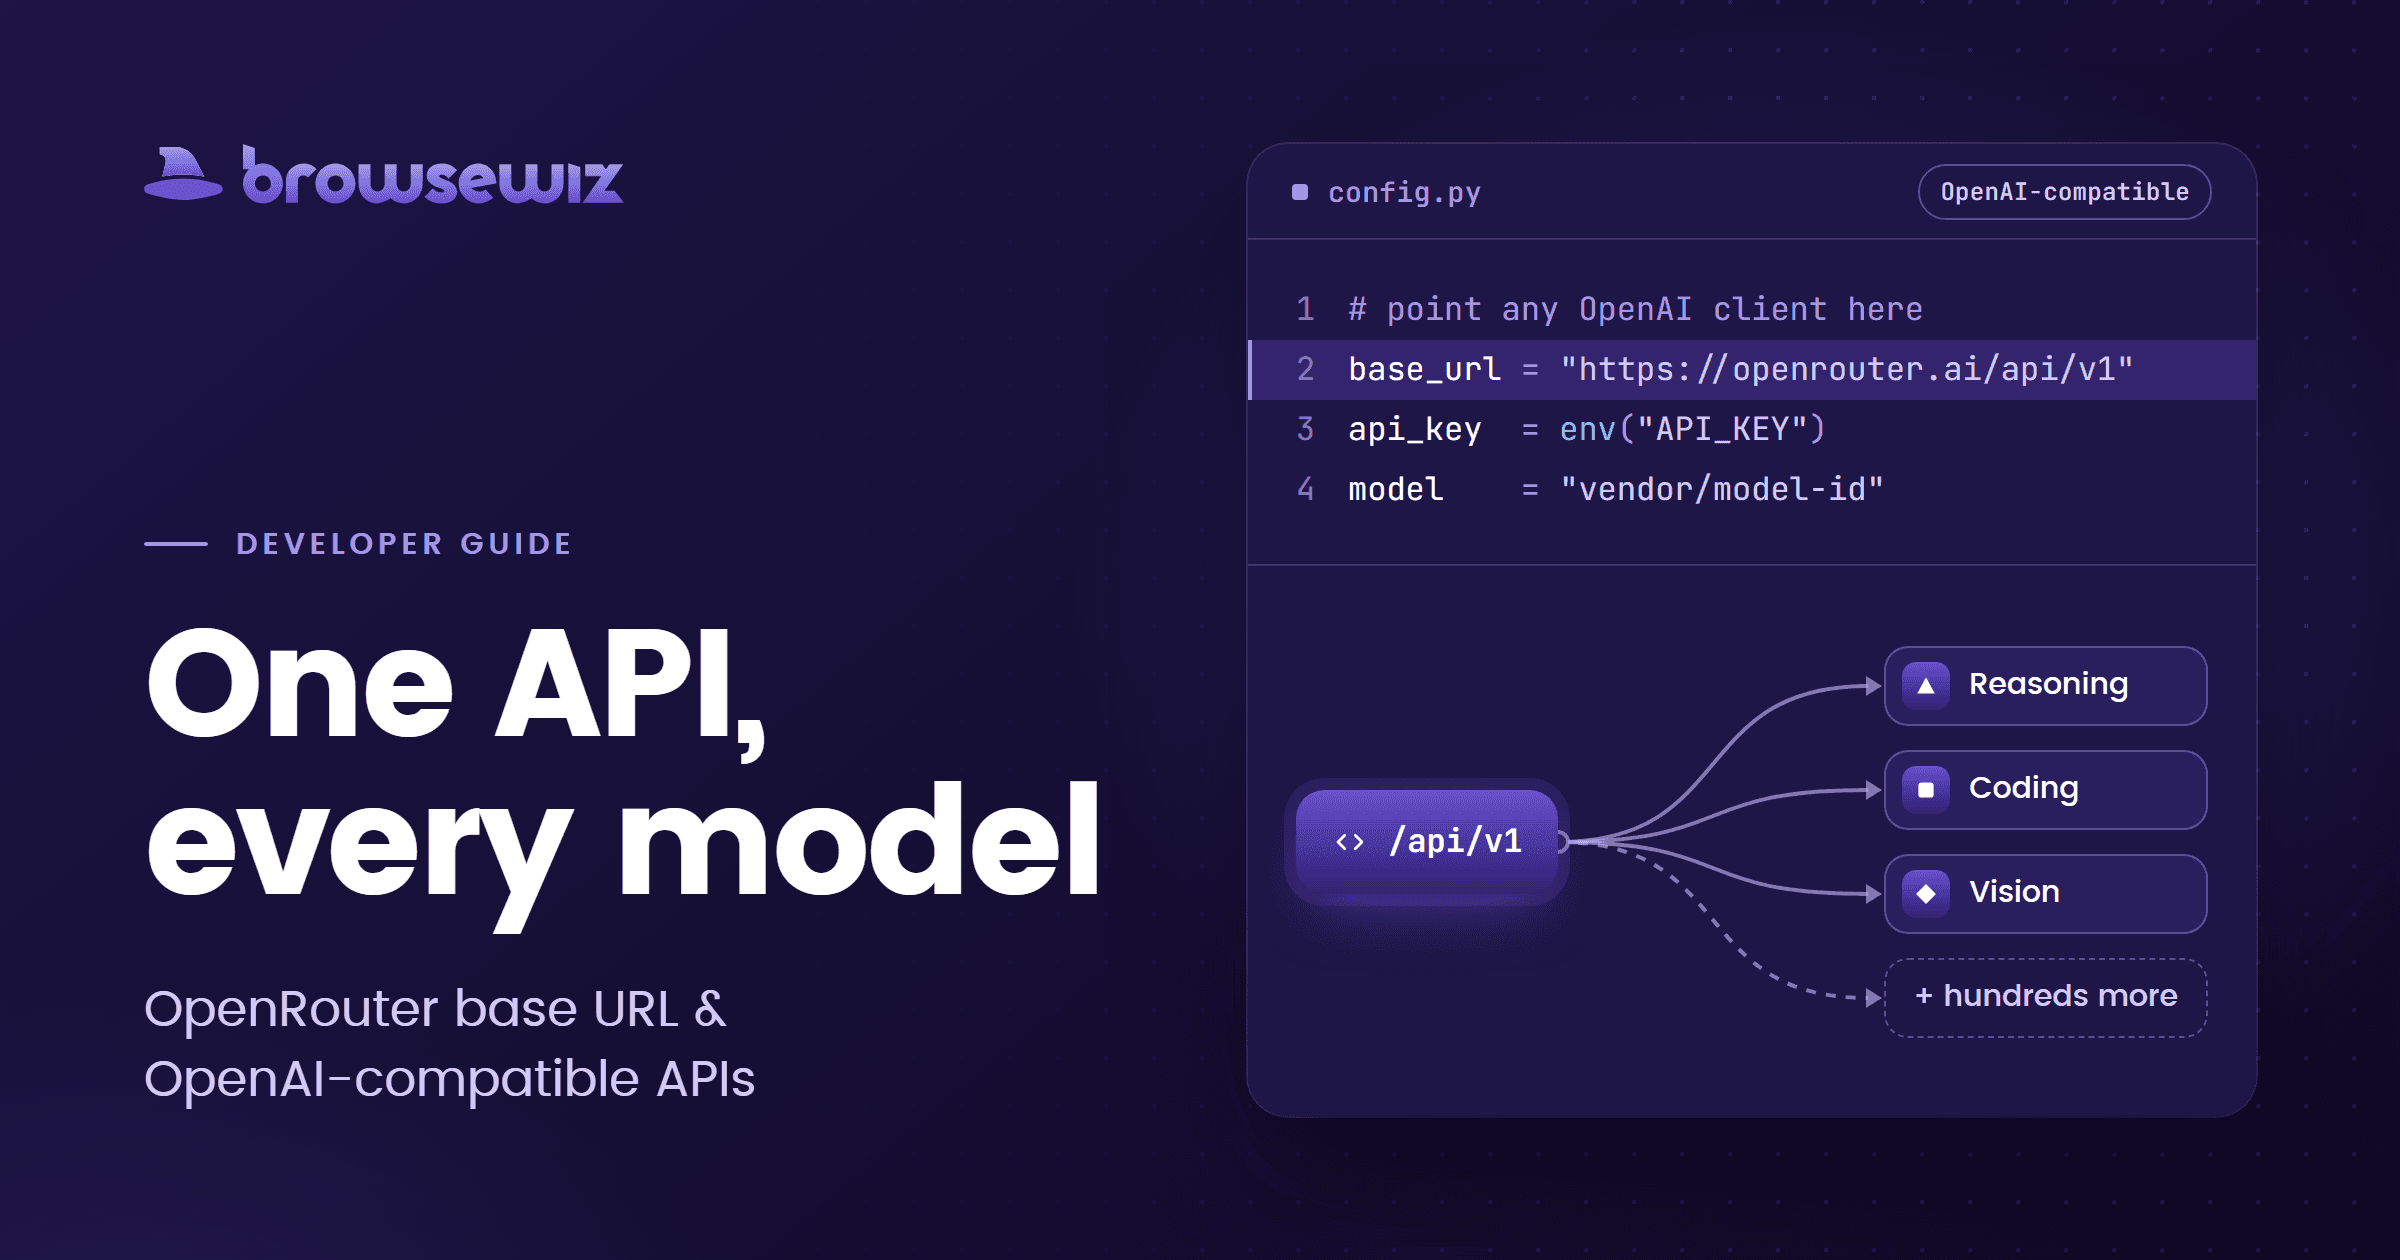
OpenRouter API i API zgodne z OpenAI: base URL oraz jeden endpoint do modeli Claude, GPT i Mistral

Base URL (adres bazowy) OpenRouter API to https://openrouter.ai/api/v1, a endpoint chat completions ma adres https://openrouter.ai/api/v1/chat/completions. OpenRouter przyjmuje żądania w formacie OpenAI Chat Completions, więc oficjalne SDK OpenAI działają z nim, gdy ustawisz ten adres jako base URL, wyślesz klucz OpenRoutera jako token Bearer i podasz model, np. anthropic/claude-sonnet-5. Po zmianie nazwy modelu na openai/gpt-6-sol albo mistralai/mistral-medium-3-5 to samo żądanie trafia do OpenAI albo do Mistrala. Vercel AI Gateway, Portkey i LiteLLM Proxy, uruchamiany na własnym serwerze, też udostępniają modele Anthropic, OpenAI i Mistral pod jednym endpointem zgodnym z API OpenAI. Porównujemy je niżej.
Wszystkie adresy URL, ID modeli i ceny w tym artykule sprawdziliśmy we wrześniu 2026 w dokumentacji i API samych dostawców.
OpenRouter API: base URL i endpoint chat completions
Ustawienie | Wartość |
|---|---|
Base URL |
|
Endpoint chat completions |
|
Nagłówek uwierzytelniania (wymagany) |
|
Typ treści |
|
Nagłówki opcjonalne |
|
Format ID modelu |
|
Klucze API |
Opcjonalne nagłówki służą tylko do przypisania żądań do twojej aplikacji: HTTP-Referer to adres twojej strony, X-OpenRouter-Title to nazwa widoczna w rankingach OpenRoutera, a X-OpenRouter-Categories przypisuje aplikację do kategorii w marketplace. Bez nich żądania też działają.
Przykład w curl
curl https://openrouter.ai/api/v1/chat/completions \
  -H "Content-Type: application/json" \
  -H "Authorization: Bearer $OPENROUTER_API_KEY" \
  -d '{
    "model": "anthropic/claude-sonnet-5",
    "messages": [
      {"role": "user", "content": "Explain what an OpenAI-compatible API is in one sentence."}
    ]
  }'
Przykład w Pythonie z oficjalnym SDK openai
Zainstaluj SDK poleceniem pip install openai, ustaw zmienną środowiskową OPENROUTER_API_KEY i uruchom:
import os
from openai import OpenAI

client = OpenAI(
    base_url="https://openrouter.ai/api/v1",
    api_key=os.environ["OPENROUTER_API_KEY"],
)

completion = client.chat.completions.create(
    model="anthropic/claude-sonnet-5",
    messages=[
        {"role": "user", "content": "Explain what an OpenAI-compatible API is in one sentence."}
    ],
    extra_headers={
        "HTTP-Referer": "https://example.com",  # opcjonalnie: adres twojej strony
        "X-OpenRouter-Title": "My App",          # opcjonalnie: nazwa twojej aplikacji
    },
)

print(completion.model)
print(completion.choices[0].message.content)
Base URL kończy się na /v1. SDK samo dopisuje /chat/completions, więc jeśli wkleisz pełny endpoint jako base_url, żądanie trafi pod .../chat/completions/chat/completions, a OpenRouter odpowie błędem 404.
ID modeli i przełączanie między modelami Claude, GPT i Mistral
ID modeli w OpenRouterze mają postać author/model. Aktualne przykłady to openai/gpt-6-sol, anthropic/claude-sonnet-5 i mistralai/mistral-medium-3-5 (prefiks Mistrala to mistralai/, nie mistral/). Endpoint, klucz i treść żądania się nie zmieniają, więc zmiana dostawcy sprowadza się do pętli po nazwach modeli (z obiektem client z poprzedniego przykładu):
for model in ["openai/gpt-6-sol", "anthropic/claude-sonnet-5", "mistralai/mistral-medium-3-5"]:
    r = client.chat.completions.create(
        model=model,
        messages=[{"role": "user", "content": "Name one risk of vendor lock-in."}],
    )
    print(f"{r.model}: {r.choices[0].message.content}")
Przy częstym przełączaniu przydają się dwie funkcje OpenRoutera. Aliasy w postaci ~author/family-latest, np. ~anthropic/claude-sonnet-latest, wskazują najnowszy model z danej rodziny, a pole model w odpowiedzi podaje, który model faktycznie obsłużył żądanie. Tablica models to lista modeli zapasowych (fallback), z których OpenRouter korzysta po kolei, gdy pierwszy model zawiedzie z powodu limitów zapytań, niedostępności, długości kontekstu albo flagi moderacji. SDK OpenAI nie ma na nią osobnego argumentu, więc przekazuje się ją jako extra_body={"models": [...]}. Płacisz za model, który udzielił odpowiedzi.
Pełny katalog modeli wraz z parametrami, które obsługuje każdy z nich, zwraca GET https://openrouter.ai/api/v1/models, i to bez klucza. Jeśli dopiero wybierasz, do jakich modeli kierować zapytania, najważniejsze opcje omawiamy w porównaniu najlepszych modeli AI.
Za inferencję OpenRouter nalicza opłaty po cenach dostawców, bez marży. Przy zakupie kredytów kartą dolicza 5,5% prowizji (minimum 0,80 USD), a przy płatności kryptowalutami 5%.
Usługi do przełączania między modelami Anthropic, OpenAI i Mistral przez jedno API
Według stanu na wrzesień 2026 OpenRouter, Vercel AI Gateway, Portkey i LiteLLM Proxy (uruchamiany na własnym serwerze) udostępniają modele Anthropic, OpenAI i Mistral pod jednym endpointem zgodnym z API OpenAI. Aktualny endpoint Cloudflare AI Gateway robi to samo dla Anthropic, OpenAI i Google. Modele Mistrala oferuje jednak tylko w wersjach open-weight (z otwartymi wagami) w Workers AI. Do API samego Mistrala potrzebny jest starszy endpoint /compat, który Cloudflare oznaczył jako przestarzały przy wywołaniach pojedynczego modelu. W każdym przypadku dostawcę zmienia się, podmieniając wartość model. Dostawcy mają też własne endpointy zgodne z API OpenAI. Przydają się, gdy chcesz używać jednej biblioteki klienckiej i nie przeszkadza ci osobny klucz u każdego dostawcy.
Opcja | Typ | Base URL zgodny z OpenAI | Do czego | Rozliczenie |
|---|---|---|---|---|
OpenRouter | Hostowany router |
| Setki modeli, jeden klucz i rachunek, modele zapasowe | Cena dostawcy bez marży; 5,5% prowizji od doładowania kartą |
Vercel AI Gateway | Hostowana bramka AI (gateway) |
| Aplikacje na Vercelu; budżety na projekt, klucz lub członka zespołu | Cena katalogowa dostawcy bez marży; kredyty przedpłacone |
Cloudflare AI Gateway | Hostowana bramka AI |
| Cache, limity zapytań i analityka dla OpenAI, Anthropic, Google | Podstawowe funkcje za darmo; 5% prowizji od kredytów |
Portkey | Hostowana bramka AI, rdzeń open source |
| Guardrails, ponawianie, równoważenie obciążenia na twoich kluczach | Za darmo do 10 tys. logów/mies.; plan za 49 USD/mies. |
LiteLLM Proxy | Proxy na własnym serwerze |
| Brak zewnętrznej bramki po drodze; budżety na klucz | Open source; płacisz dostawcom |
Hugging Face Inference Providers | Hostowany router, modele open-weight |
| Otwarte modele serwowane przez Groq, Cerebras, Together i innych | Bez marży na stawkach dostawców; darmowy plan |
Together AI | Hosting modeli open-weight |
| Otwarte modele z narzędziami, obsługą obrazów i structured output | Za 1 mln tokenów |
OpenAI | Dostawca |
| Implementacja referencyjna | Za tokeny |
Anthropic | Warstwa zgodności dostawcy |
| Testowanie Claude na kodzie napisanym pod OpenAI | Za tokeny |
Google Gemini | Warstwa zgodności dostawcy (beta) |
| Gemini z poziomu SDK OpenAI | Darmowy plan, potem za tokeny |
Mistral | Dostawca |
| Modele Mistral; zmieniasz tylko base URL i model | Za 1 mln tokenów |
Jak wybrać
Jeśli nie chcesz zakładać konta u każdego dostawcy, OpenRouter, Vercel AI Gateway i Unified Billing w Cloudflare sprzedają tokeny po cenach dostawców z jednego przedpłaconego salda. Gdy sprawdzaliśmy (wrzesień 2026), API modeli OpenRoutera zwracało 356 różnych modeli, nie licząc aliasów i wariantów :free oraz :batch, a API Vercela 265 modeli językowych. Kiedy liczy się szeroki wybór modeli, OpenRouter ma przewagę. Vercel i Cloudflare mają więcej sensu, gdy twoja aplikacja już na nich działa.
Jeśli masz już klucze u dostawców, Portkey i LiteLLM działają jako warstwa przed nimi. Portkey dodaje ponawianie żądań, modele zapasowe, równoważenie obciążenia i guardrails, a jego darmowy plan obejmuje 10 000 zapisanych logów miesięcznie. LiteLLM śledzi wydatki i ustawia budżety dla wirtualnych kluczy. Wybierz go, gdy żadna zewnętrzna bramka nie może widzieć twojego ruchu.
ID modeli nie przenoszą się między bramkami. OpenRouter zapisuje mistralai/mistral-medium-3-5, Vercel mistral/mistral-medium-3.5, Portkey używa formatu @your-provider-slug/model, a LiteLLM nazwy, którą sam zdefiniujesz w model_name. Warstwy zgodności Anthropic i Gemini to najsłabszy wybór na produkcję. Anthropic przedstawia swoją jako sposób na testowanie i porównywanie modeli, nie jako rozwiązanie długoterminowe. Google wciąż oznacza swoją jako beta.
Na własnym serwerze: jeden endpoint z LiteLLM
Konfiguracja LiteLLM, która udostępnia modele Claude, GPT i Mistral pod krótkimi nazwami:
model_list:
  - model_name: claude
    litellm_params:
      model: anthropic/claude-sonnet-5
      api_key: os.environ/ANTHROPIC_API_KEY
  - model_name: gpt
    litellm_params:
      model: openai/gpt-6-sol
      api_key: os.environ/OPENAI_API_KEY
  - model_name: mistral
    litellm_params:
      model: mistral/mistral-large-latest
      api_key: os.environ/MISTRAL_API_KEY
docker run -v $(pwd)/litellm_config.yaml:/app/config.yaml \
-e ANTHROPIC_API_KEY -e OPENAI_API_KEY -e MISTRAL_API_KEY \
-e LITELLM_MASTER_KEY=sk-change-me \
-p 4000:4000 docker.litellm.ai/berriai/litellm:latest --config /app/config.yamlKlienci ustawiają wtedy base URL na http://localhost:4000, klucz API na sk-change-me, a model na claude, gpt albo mistral. Bez bazy danych LiteLLM nie egzekwuje budżetów.
Co oznacza API zgodne z OpenAI i gdzie ta zgodność się kończy
API zgodne z OpenAI przyjmuje POST {base_url}/chat/completions z treścią JSON w formacie OpenAI (model, messages z rolami, opcjonalnie tools i stream), uwierzytelnia klienta tokenem Bearer i zwraca odpowiedź o tej samej strukturze choices[].message, a przy streamingu strumień server-sent events. Zwykłe zapytania czatu działają na każdym endpoincie z tabeli po zmianie base URL, klucza i nazwy modelu. Różnice wychodzą dopiero przy funkcjach spoza tego minimum:
Wywoływanie narzędzi (tool calling): warstwa Anthropic ignoruje
strict, więc argumenty narzędzi nie muszą pasować do twojego schematu. W OpenRouterze 67 z 356 różnych modeli nie miałotoolsna liściesupported_parameters, gdy sprawdzaliśmy (wrzesień 2026), więc zanim podłączysz model do agenta, zajrzyj na tę listę.Ustrukturyzowane odpowiedzi (structured output): warstwa Anthropic ignoruje
response_format. Together AI i Vercel AI Gateway deklarują w dokumentacji jego obsługę.Streaming: OpenRouter wysyła komentarze podtrzymujące połączenie (
: OPENROUTER PROCESSING). SDK je pomijają, ale własny parser SSE musi odrzucać linie zaczynające się od:przed parsowaniem JSON-a. Błąd, który wystąpi po rozpoczęciu strumienia, przychodzi jako fragment (chunk) zfinish_reason: "error"w odpowiedzi HTTP 200.Sterowanie rozumowaniem: nie ma wspólnego parametru. Warstwa Anthropic ignoruje
reasoning_efforti przyjmuje obiektthinkingprzezextra_body. Gemini przyjmujereasoning_effortalbo własnethinking_level/thinking_budget, ale nie oba naraz. OpenRouter używa obiektureasoningz polemeffortalbomax_tokens.Obrazy i pliki: warstwa Anthropic odczytuje części
image_url, ale odrzuca częścifileiinput_audio.Prompty systemowe i parametry próbkowania: Anthropic łączy wszystkie wiadomości z rolami system i developer w jeden prompt systemowy na początku rozmowy, ogranicza
temperaturedo 1 i wymaga, bynwynosiło 1.
Pisz kod pod wspólny podzbiór (wiadomości, streaming, narzędzia bez strict), a parametry specyficzne dla dostawcy trzymaj w extra_body, ustawianym osobno dla każdego z nich.
Jak używać dowolnego modelu zgodnego z API OpenAI w BrowseWiz
BrowseWiz to asystent AI w panelu bocznym przeglądarek Chrome i Edge. W ustawieniach niestandardowych modeli przyjmuje każdy model, który udostępnia endpoint chat completions zgodny z API OpenAI. Potrzebuje tych samych trzech wartości co SDK:
Otwórz stronę ustawień BrowseWiz (otwiera ją ikona konta w prawym dolnym rogu panelu bocznego) i wybierz Modele.
W sekcji Niestandardowe punkty końcowe modeli kompatybilnych z API OpenAI (polski interfejs nazywa endpointy punktami końcowymi) wpisz nazwę modelu dokładnie tak, jak dostawca oczekuje jej w żądaniu, np.
anthropic/claude-sonnet-5dla OpenRoutera.Wpisz base URL, np.
https://openrouter.ai/api/v1. BrowseWiz sam dopisuje/chat/completions, więc i tutaj zakończ adres na/v1.Wklej klucz API. BrowseWiz szyfruje go i przechowuje w lokalnym magazynie rozszerzenia.
Każdy wpis to jeden model. Żeby korzystać z modeli Claude, GPT i Mistral przez OpenRouter, dodaj trzy wpisy z tym samym base URL i kluczem, ale z różnymi nazwami modeli. Bezpośrednie endpointy dostawców działają tak samo:
Dostawca | Base URL | Przykładowa nazwa modelu |
|---|---|---|
OpenRouter |
|
|
Google Gemini |
|
|
Mistral |
|
|
Anthropic |
|
|
Jeśli potrzebujesz tylko modeli OpenAI, sekcja Użyj własnego klucza (BYOK) na tej samej stronie przyjmuje klucz OpenAI bezpośrednio. Bez żadnego klucza wbudowany model BrowseWiz Chat działa w darmowym planie z limitem użycia. Na stronie ustawień można też dodać własne narzędzia API i webhooki. Przykład takiego narzędzia pokazujemy w tekście o automatyzacji faktur i paragonów w n8n.
Najczęściej zadawane pytania
Co to jest OpenRouter?
OpenRouter to hostowany router modeli AI: jedno API zgodne z OpenAI, przez które jednym kluczem i z jednego przedpłaconego salda korzystasz z setek modeli różnych dostawców, m.in. Anthropic, OpenAI i Mistral. Model wybierasz polem model, np. anthropic/claude-sonnet-5; za inferencję płacisz ceny dostawców bez marży, a prowizję OpenRouter pobiera przy zakupie kredytów.
Jaki jest base URL OpenRouter API?
https://openrouter.ai/api/v1. Endpoint chat completions to https://openrouter.ai/api/v1/chat/completions, a uwierzytelnianie odbywa się nagłówkiem Authorization: Bearer <OPENROUTER_API_KEY>.
Czy OpenRouter jest zgodny z API OpenAI?
Tak. OpenRouter przedstawia się jako bezpośredni zamiennik OpenAI (drop-in replacement) i działa z każdym SDK, w którym można ustawić base URL. Opcje dostępne tylko w OpenRouterze, takie jak models, provider i reasoning, w SDK OpenAI dla Pythona przekazuje się w extra_body.
Czy można przełączać się między modelami Anthropic, OpenAI i Mistral, mając jeden klucz API?
Tak. OpenRouter i Vercel AI Gateway rozliczają modele Claude, GPT i Mistral z jednego klucza i jednego przedpłaconego salda. Cloudflare AI Gateway robi to samo dla modeli Claude i GPT, ale nie dla API Mistrala. Portkey i LiteLLM też dają jeden klucz do bramki, ale za nią trzymasz własne klucze dostawców.
Czy base URL powinien zawierać /chat/completions?
Nie. SDK OpenAI i BrowseWiz same dopisują /chat/completions do base URL. Jeśli dodasz tę ścieżkę sam, pojawi się w adresie dwa razy, a OpenRouter odpowie błędem 404.
Czy API Anthropic jest zgodne z API OpenAI?
Częściowo. Anthropic udostępnia warstwę zgodności z SDK OpenAI pod adresem https://api.anthropic.com/v1/, ale ignoruje w niej m.in. response_format, reasoning_effort i ścisłe schematy narzędzi, a samą warstwę opisuje jako przeznaczoną do testowania i porównywania modeli. OpenRouter podaje response_format, structured_outputs i reasoning jako obsługiwane parametry dla modeli Claude 4.5 i nowszych, więc jeśli potrzebujesz tych funkcji w formacie OpenAI, to prostsza droga.
About Tom
I'm a software engineer and solutions architect specializing in AI-driven tools and productivity software, passionate about helping users reclaim their valuable time through intelligent automation.